Компьютерный мозг, абстракция
Искусственный интеллект – не изобретение последних лет, а циклично развивающаяся область, где периоды технологического прорыва сменяются «зимами» разочарования и сокращения финансирования. За 80 лет отрасль прошла путь от ламповых машин с памятью в десятки килобайт до ЦОД на сотни мегаватт и триллионной индустрии.
Нынешняя волна отличается не столько самим фактом появления чат-ботов и ИИ-агентов, сколько сочетанием языковых моделей, огромных вычислительных мощностей, облачной инфраструктуры и массового потребительского спроса.
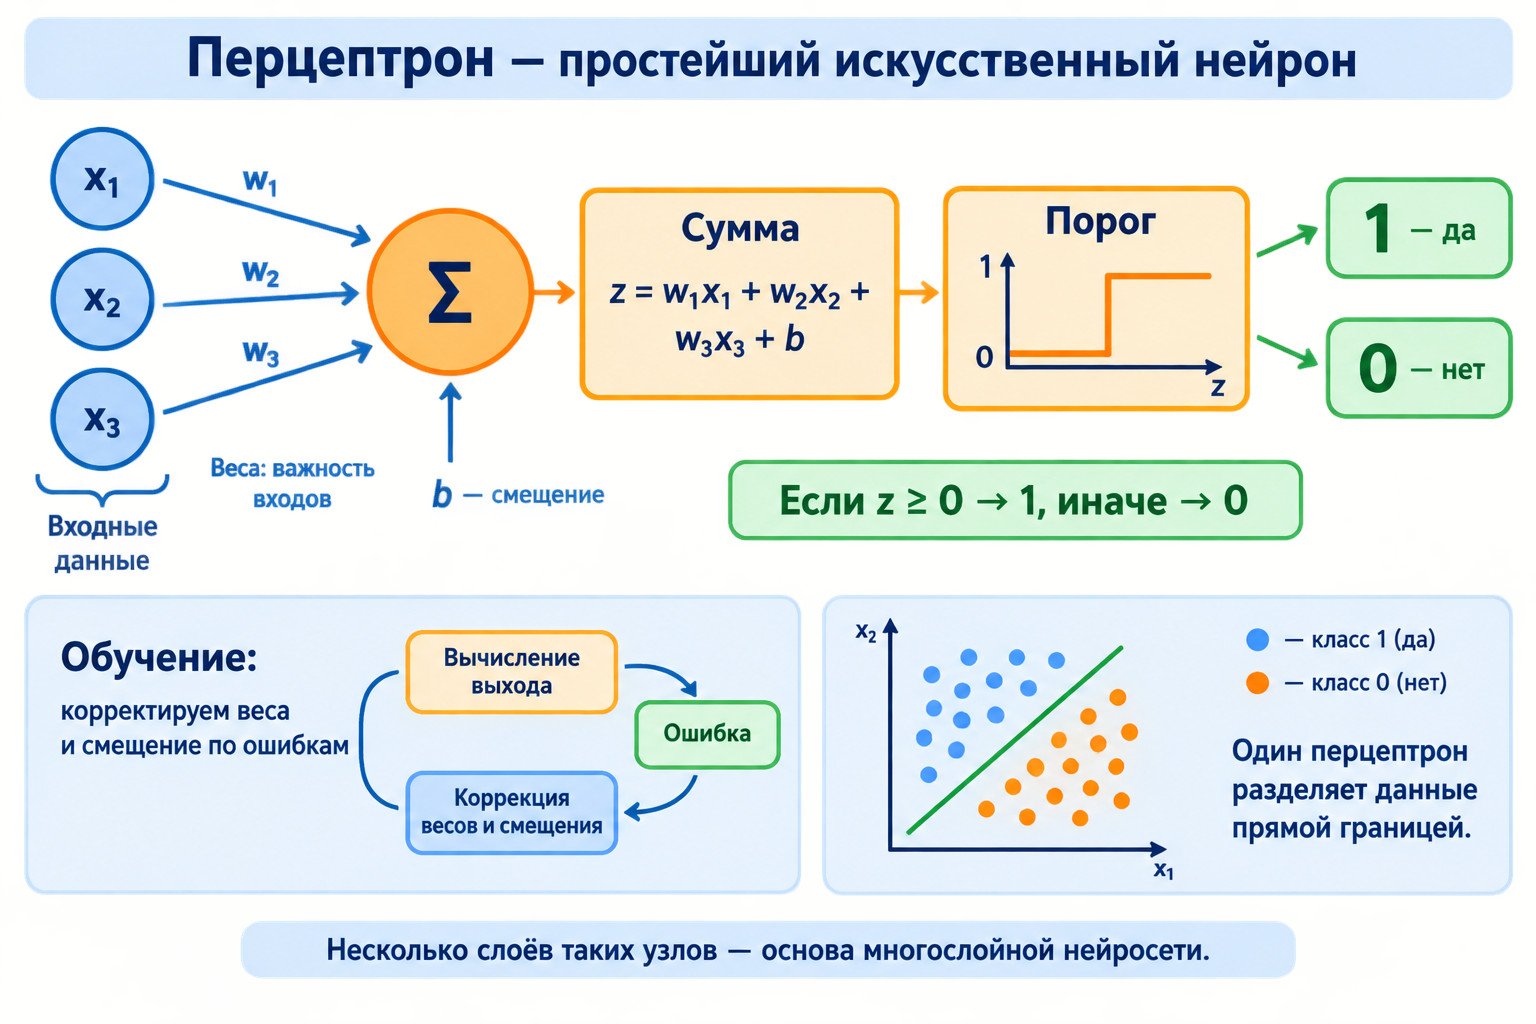
Перцептрон
Первая волна: теоретический фундамент
1943–1974 гг. Теоретическое обоснование, Тьюринг, перцептроны
ИИ, как и ряд других повседневных технологий, получил начальное финансирование благодаря военным и научным заказчикам. В 1943 году американские ученые Уоррен Мак-Каллок и Уолтер Питтс заложили основы индустрии, предложив математическую модель нейрона и формализовав принципы вычисления логических функций сетью простых элементов, а в 1949 году Дональд Хебб описал правило усиления связей при обучении.
Наиболее известным теоретиком волны стал Алан Тьюринг, предложивший в 1950 году «игру в имитацию» как способ рассуждать о думающих машинах. Он полагал, что интеллектуальное поведение воспроизводимо машиной, и ожидал, что к 2000 году компьютеры с памятью около 1 млрд бит (125 МБ) смогут вести диалог так, что после 5 минут вопросов судья распознает машину с вероятностью не выше 70%. Термин «искусственный интеллект» закрепился 6 годами позже на 8-недельном Дартмутском семинаре в Нью-Гэмпшир на грант Фонда Рокфеллера в 7500 долларов (из запрошенных 13 500).
По итогам первой волны ИИ получил теоретический фундамент, но оказался слабым для универсальных задач. Созданный Фрэнком Розенблаттом в 1957–1958 годах однослойный перцептрон Mark I считывал образы матрицей из 400 фотоэлементов (20 на 20 пикселей) и менял 512 весов потенциометрами с моторами, но не решал сложные проблемы. В 1969 году Марвин Минский и Сеймур Паперт доказали его неспособность вычислить функцию «исключающее «или»» (XOR). Программы решали формальные задачи – в Джорджтаунском эксперименте 1954 года IBM 701 перевел 60 русских фраз на английский со словарем из 250 слов и 6 правил, – но идти дальше мешал дефицит данных и мощностей. Передовой компьютер эпохи IBM 704 выполнял до 40 тыс. инструкций (12 тыс. операций с плавающей запятой) в секунду при памяти от 4096 до 32 768 36-битных слов (18–147 КБ).
Основным документом, окончившим волну, стал доклад Лайтхилла в 1973 году, отделивший возможности машин от непомерных ожиданий и указавший на «комбинаторный взрыв» вычислений, что сократило господдержку в Великобритании на 90%.
В США переоценка шла независимо: в 1966 году доклад комитета ALPAC после затрат в 20 млн долларов признал машинный перевод вдвое дороже и менее точным, чем труд человека, а поправка Мэнсфилда (1969) и слабые итоги речевой программы SUR (3 млн долларов в год) заставили DARPA урезать гранты. Первую «зиму ИИ» датируют 1974–1980 годами, хотя предпосылки кризиса появились еще в 1960-х.
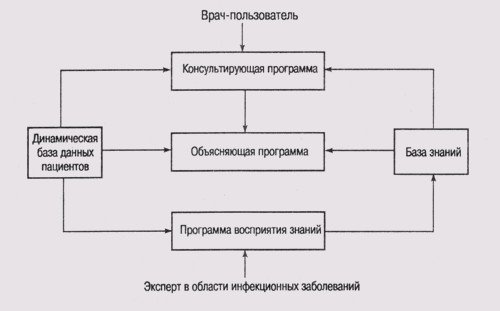
Схема работы MYCIN Expert System
Вторая волна: экспертные системы
1980–1987 гг. Экспертные системы, многослойность, первый опыт коммерциализации
Вместо создания универсального разума разработчики переключились на экспертные системы – узкоспециализированные программы, хранившие свод правил и выдававшие ответ. Созданная в Стэнфорде в 1972 году система MYCIN диагностировала инфекции крови и рекомендовала антибиотики на базе около 600 правил, показав в 1979 году точность 65% против 42,5–62,5% у врачей факультета.
Во время второй волны такие решения внедрили корпорации: запущенная в 1980 году в DEC система R1/XCON для сборки заказов на компьютеры VAX выросла с 750 до 2500 правил к 1986 году (и свыше 6200 позже), обработала 80 тыс. заказов с точностью 95–98% и экономила по 25–40 млн долларов в год.
К середине 1980-х рынок ИИ достиг 1–2 млрд долларов в год, а Япония в 1982 году вложила 57 млрд иен (400 млн долларов) в проект компьютеров пятого поколения со скоростью до 1 млрд логических выводов в секунду, на что США ответили программой DARPA на 1 млрд долларов.
Параллельно исследователи преодолели ограничения перцептрона. В 1982 году Джон Хопфилд предложил ассоциативную сеть, а в 1986 году Джеффри Хинтон, Дэвид Румельхарт и Рональд Уильямс популяризовали метод обратного распространения ошибки (backpropagation) для обучения многослойных сетей, после чего в 1989 году группа Яна Лекуна применила сверточные сети для чтения почтовых индексов в США.
Тогда ИИ впервые стал продуктом, но экспертная модель оказалась плохо масштабируемой. В конце 1980-х стало ясно, что приходится постоянно переписывать устаревающие инструкции (в XCON ежегодно меняли до 50% правил), к тому же выросла конкуренция со стороны обычных ПК: станции Sun, компьютеры IBM и Apple дешевле 10 тыс. долларов вытеснили Lisp-машины за 50–150 тыс. долларов, обрушив в 1987 году полумиллиардный рынок ИИ-железа и вызвав вторую «зиму ИИ».
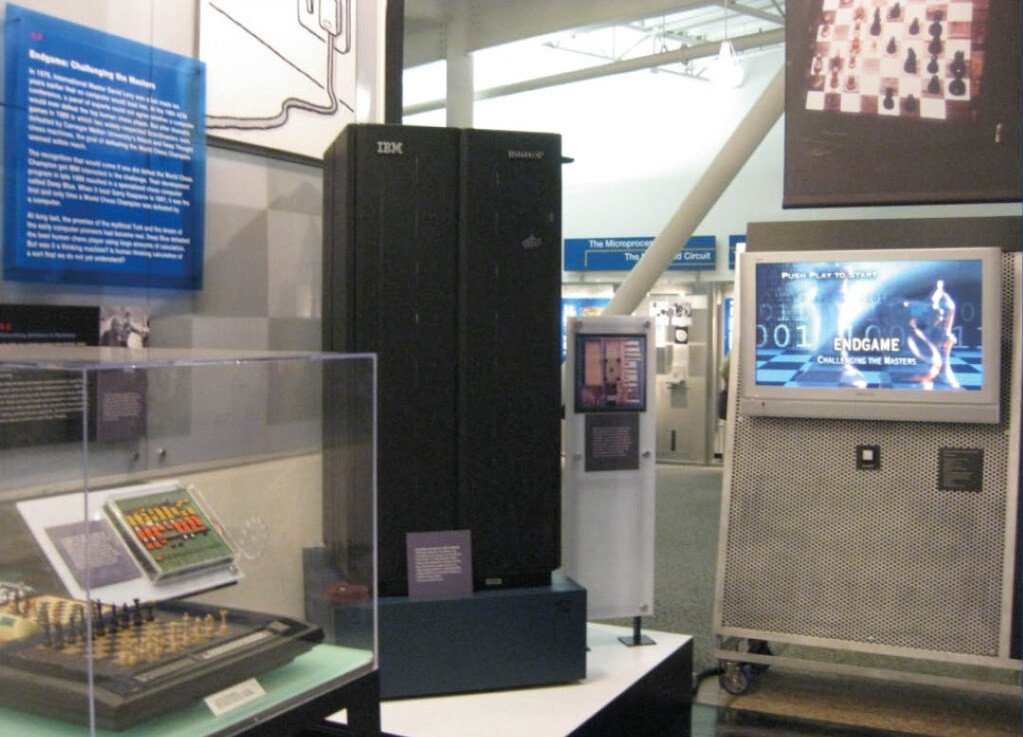
Одна из двух стоек Deep Blue в Музее компьютерной истории
Третья волна: статистическое обучение
1990-е – 2010-е гг. Подготовка больших данных, прогнозные модели, Google
Основное нововведение волны – переход от символических правил к статистическому обучению. Разработчики стали строить модели на основе больших массивов исторических данных, а не только на базе знаний экспертов. Тогда возникло значительное число методов и архитектур, которые применяются и сегодня, включая метод опорных векторов (SVM, 1995) и сети долгой краткосрочной памяти (LSTM, 1997).
Однако эффективными оставались в основном специализированные модели. Суперкомпьютер Deep Blue от IBM в 1997 году обыграл Гарри Каспарова в шахматы (3,5 на 2,5): система из 30 узлов RS/6000 SP (120 МГц) и 480 шахматных чипов оценивала до 200 млн позиций в секунду и развивала мощность 11,38 гигафлопс, занимая 259-е место в TOP500.
Также шла подготовка больших данных для прорыва. Датасет ImageNet (14 млн фото) позволил в 2012 году сверточной нейросети AlexNet из 60 млн параметров и 650 тыс. нейронов снизить ошибку распознавания с 26,2% до 15,3%, обучившись за 5–6 дней на двух картах NVIDIA GTX 580 (по 3 ГБ памяти и 1,58 терафлопс).
В 2017 году вышла статья Attention Is All You Need («Внимание – это все, что вам нужно») от исследователей Google – передовой лаборатории ИИ третьей волны (прославившейся и победой AlphaGo над Ли Седолем в 2016 году). Механизм self-attention позволил модели учитывать связи между удаленными элементами последовательности и обучаться параллельно: базовая модель на 65 млн параметров обучилась за 12 часов на 8 чипах NVIDIA P100 (по 16 ГБ памяти), а большая (213 млн) – за 3,5 дня (23 квинтиллиона операций), открыв путь к масштабированию до GPT-3 (175 млрд параметров в 2020 году).
Третья волна не закончилась «зимой», так как алгоритмы в поиске и рекламе уже приносили корпорациям десятки миллиардов долларов, но она четко отделяется от последующего взрыва популярности ИИ.
Логотип ChatGPT
Четвертая волна: генеративный прорыв
2022 г. – наши дни. Массовость, генеративность, гонка вооружений
30 ноября 2022 года запуск ChatGPT сделал диалоговый генеративный ИИ массовым продуктом, когда сервис набрал 100 млн пользователей за два месяца, а к осени 2026 года его недельная аудитория достигла 1,2 млрд человек (планку в 1 млрд в месяц взяли также Gemini и Meta AI). За четыре года OpenAI и компании в США (Anthropic, Google, Meta, xAI), Китае (DeepSeek, Alibaba Qwen, Baidu) и странах-преследователях, включая Россию (YandexGPT и GigaChat), кратно увеличили мощность моделей.
Флагманские системы выросли до 600 млрд – 2 трлн параметров с окном контекста в 1–2 млн токенов, а их обучение требует свыше 10 в 25-й степени операций на кластерах из 100 тыс. чипов. Один ускоритель NVIDIA Blackwell B200 несет 192 ГБ памяти HBM3e (8 ТБ/с) и выдает до 4,5–9 петафлопс. Капитализация NVIDIA выросла с 360 млрд до более чем 5 трлн долларов в 2026 году при выручке 215,9 млрд долларов, а годовые капзатраты четырех облачных гигантов США (Microsoft, Alphabet, Amazon, Meta) на ИИ-инфраструктуру в 2026 году достигли 650–700 млрд долларов.
Появились агенты, способные выходить за контур чата и влиять на окружающий мир, коммерческое применение ИИ нашлось в большинстве сфер от военных технологий до образования и медицины. Такая демократизация достигнута за счет общения с моделями на обычном языке вместо языка программирования.
Сначала ученые формализовали вычисление и обучение, затем научились превращать экспертные знания в программы, после – извлекать закономерности из больших данных. Нынешний этап сделал эти возможности доступными через обычный язык и за 2023–2026 годы снизил стоимость генерации миллиона токенов более чем в 100 раз.
Однако проблема соответствия успешных демонстраций и эффективности в реальных задачах, характерная для первых трех волн, проявляется и в четвертой. Галлюцинации моделей, сбои агентов, дефицит энергии для ЦОД и разрыв между сотнями миллиардов долларов вложений и их окупаемостью могут вновь охладить интерес к отрасли до появления новых технологических прорывов.